Проблемы общего использования базы данных и пути их решения при переходе на микросервисную архитектуру
Технический разбор проблем общего использования баз данных и сложностей поддержания целостности данных при переходе от монолитных систем к микросервисам.
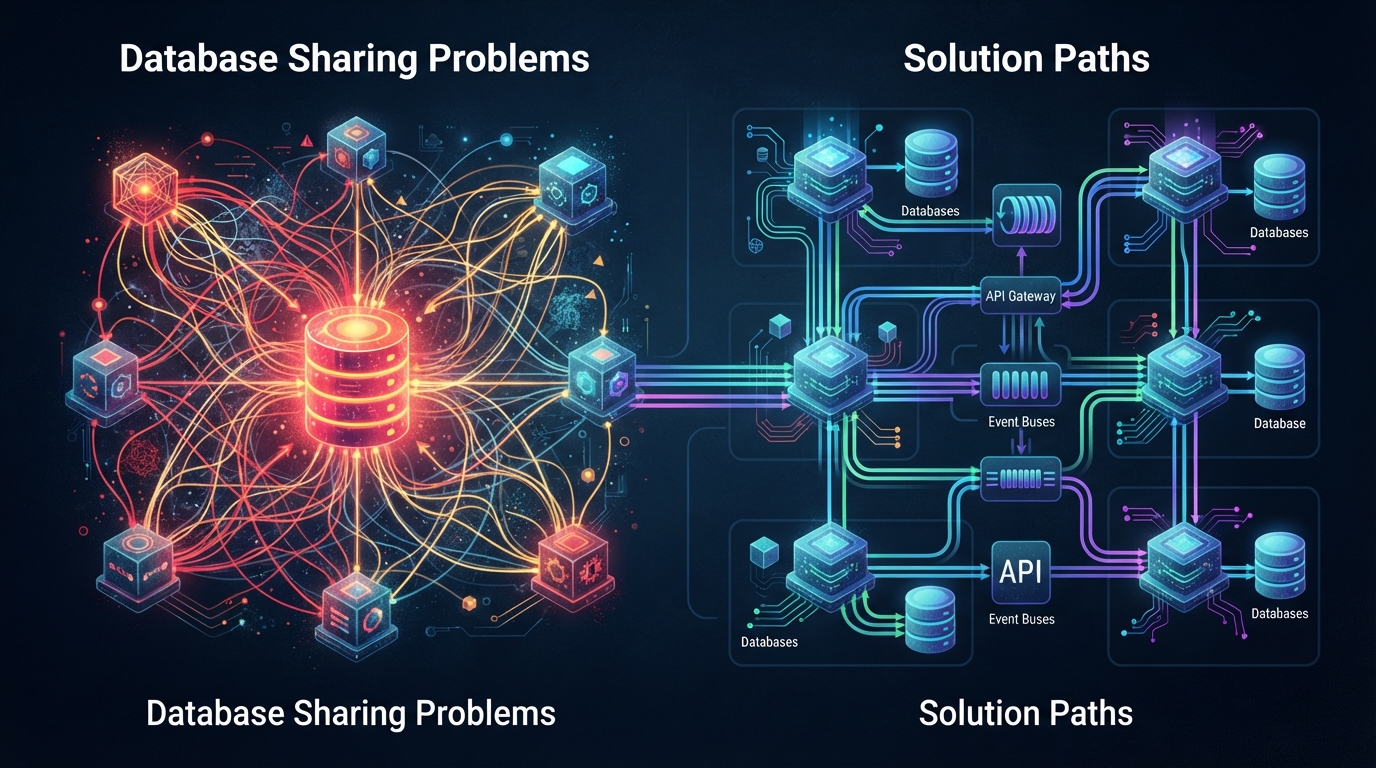
Переход от монолитных структур к современным архитектурам является критическим поворотным моментом для бизнеса. Особенно в проектах Kurumsal Yazılım & ERP при управлении множеством отделов и процессов под одной крышей техническая инфраструктура такого перехода требует огромного внимания. Одной из фундаментальных трудностей, возникающих при шаге в мир распределенных систем, являются проектирование архитектуры баз данных и модели доступа сервисов к данным.
Антипаттерн общей базы данных и связанные с ним риски
Первая ловушка, в которую попадают команды, переходящие от монолитных систем к микросервисной архитектуре, заключается в том, что все сервисы продолжают использовать одну и ту же базу данных. Хотя такой подход обеспечивает удобство в краткосрочной перспективе, в долгосрочной перспективе он полностью противоречит принципам распределенных систем.
- Жесткая связанность (Tight Coupling): Зависимость между сервисами не уменьшается, а напротив, возрастает на уровне базы данных.
- Препятствие для масштабирования: Сервисы, находящиеся под различной нагрузкой, конкурируют за одни и те же ресурсы базы данных.
- Конфликты изменения схемы: Обновление таблиц в одном сервисе может нарушить работу кода других сервисов.
Стратегии обеспечения целостности данных
Наличие у каждого микросервиса собственной базы данных (Database-per-Service) усложняет управление целостностью данных. Операции выходят за рамки единых границ транзакций ACID и переносятся в распределенные структуры.
Реализация паттерна Saga
Для управления процессами, состоящими из комбинации локальных транзакций в распределенных системах, используется паттерн Saga. Этот подход может быть реализован двумя различными методами:
- Хореография (Choreography): Сервисы прослушивают события друг друга, запуская собственные локальные операции и продвигая процесс вперед.
- Оркестрация (Orchestration): Централизованный сервис (оркестратор саги) контролирует последовательность всех шагов и в случае возможных ошибок задействует компенсирующие операции.
CQRS и архитектура на основе событий
В сложных сценариях корпоративного ПО разделение операций чтения и записи является обязательным с точки зрения производительности. Благодаря паттерну разделения ответственности команд и запросов (CQRS) изменения данных асинхронно передаются другим сервисам. Таким образом, архитектура базы данных способна с легкостью справляться с различными рабочими нагрузками.
Пошаговая дорожная карта перехода
Для безопасного завершения процесса перехода необходимо выполнить следующие шаги:
- Моделирование домена (Domain Modeling): Разделите бизнес-процессы на правильные границы ограниченного контекста (bounded context).
- Разделение данных: Поэтапно перенесите таблицы из общей базы данных в соответствии с зонами ответственности микросервисов.
- Асинхронная синхронизация: Используйте надежные брокеры сообщений (message brokers) для устранения несогласованности данных между сервисами.
Гипотетический сценарий: интеграция заказов и склада
Рассматривая этот теоретический сценарий, давайте изучим разделение сервисов заказов и склада в корпоративной архитектуре на базе электронной коммерции. В монолитной структуре при создании заказа таблица склада обновлялась напрямую. При переходе на микросервисы эти две области были разделены, и для каждого сервиса была спроектирована своя база данных. Когда пользователь оформляет заказ, Сервис Заказов записывает новую запись в собственную базу данных и генерирует событие SiparisOlusturuldu. Сервис Склада прослушивает это событие и уменьшает количество товара в своей базе данных. Однако здесь возникает критический компромисс (trade-off): вместо строгой согласованности (strong consistency) принимается конечная согласованность (eventual consistency). Если Сервис Склада не может ответить из-за сбоя сети или ошибок брокера сообщений, таблица заказов и таблица склада временно не совпадают. Для управления этой ошибкой задействуются компенсирующие операции. Если запасов недостаточно, оркестратор саги отправляет компенсирующую команду для отмены заказа. На этапе обработки ошибок настраиваются механизмы очередей мертвых сообщений (dead-letter queue), что позволяет логировать необрабатываемые сообщения и дает системным администраторам возможность ручного вмешательства.
Подробный контрольный список перехода и реализации
Для безопасного управления процессом перехода от общей базы данных к изолированным базам данных микросервисов необходимо применять контрольный список, состоящий из определенных шагов. На первом этапе ограниченный контекст (bounded context) каждого сервиса должен быть четко определен, а прямые SQL-запросы соединения (join) между сервисами должны быть полностью исключены. На втором этапе владение общими таблицами передается одному сервису, в то время как для доступа других сервисов к этим данным в режиме чтения создаются уровни проецирования на основе API или CQRS. На третьем этапе, чтобы свести к минимуму время простоя (downtime) во время миграции данных, в проект интегрируются инструменты двойной записи (dual-write) или захвата измененных данных (CDC). На четвертом этапе сценарии сбоев распределенных операций симулируются из конца в конец и подвергаются нагрузочным тестированиям. Самым большим сбоем, с которым сталкиваются в этом процессе, является дублированная (duplicate) обработка сообщений в асинхронных потоках. Чтобы предотвратить это, в кодовую базу обязательно должны быть внедрены идемпотентные (дающие тот же результат при повторных вызовах) потребительские реализации. На завершающем этапе все метрики системы тщательно анализируются с помощью инструментов мониторинга, и устраняются узкие места производительности.
Источники
- Kurumsal Yazılım & ERP — Cy Logic Software