چالشهای اشتراکگذاری پایگاه داده و راه حلهای آن در گذر به معماری میکروسرویس
چالشهای اشتراکگذاری پایگاه داده و مشکلات یکپارچگی دادهها در گذر از سیستمهای یکپارچه (Monolithic) به میکروسرویسها را با گامهای فنی بررسی میکنیم.
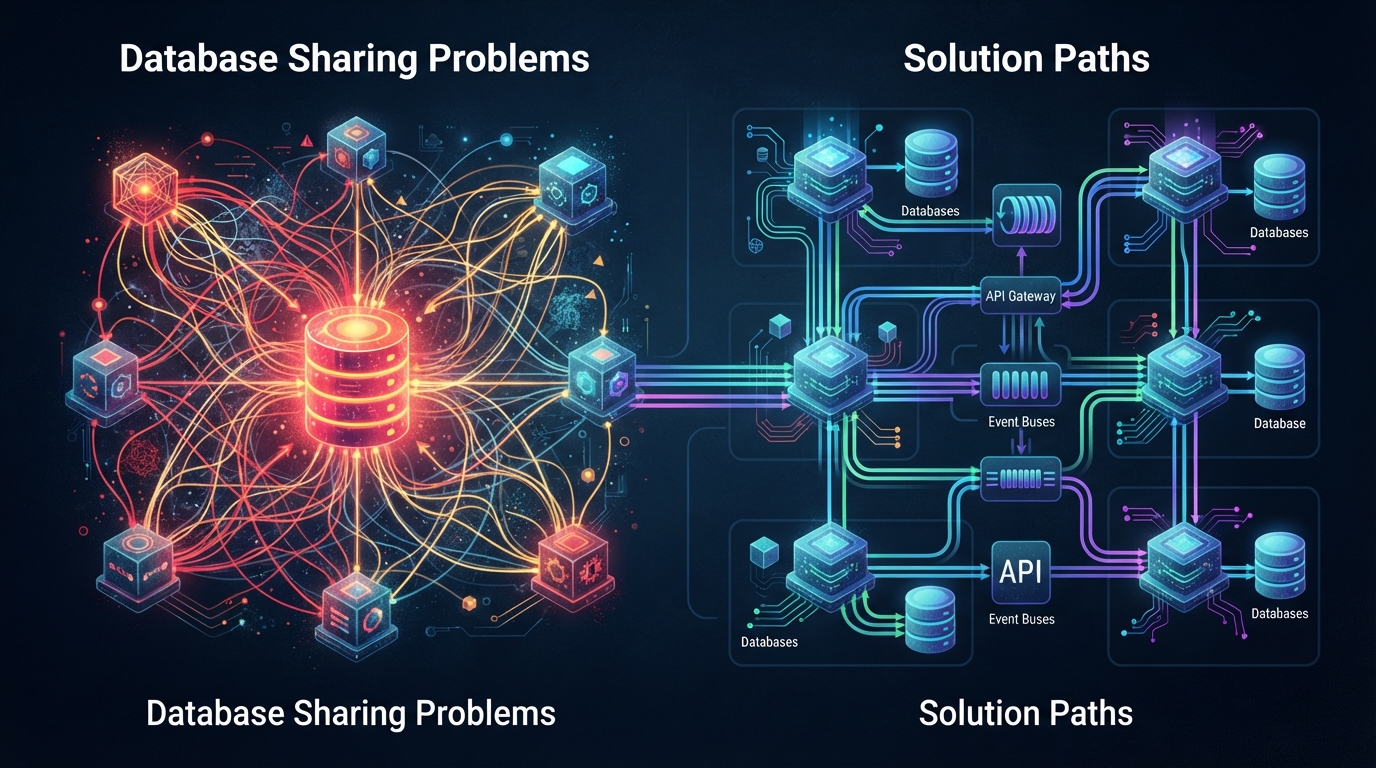
گگذر از ساختارهای یکپارچه (Monolithic) به معماریهای مدرن، یک نقطه عطف حیاتی برای کسبوکارها است. به ویژه در پروژههای Kurumsal Yazılım & ERP که در آن چندین دپارتمان و فرایند تحت یک سقف مدیریت میشوند، زیرساخت فنی این گذار نیازمند توجه ویژهای است. یکی از چالشهای بنیادی هنگام قدم گذاشتن به دنیای سیستمهای توزیعشده، پیکربندی معماری پایگاه داده و مدلهای دسترسی سرویسها به دادهها است.
الگوی ضد اشتراکگذاری پایگاه داده و ریسکهای آن
اولین تلهای که تیمهای در حال تکامل از سیستمهای یکپارچه به ساختار میکروسرویس در آن میافتند این است که تمام سرویسها به اشتراکگذاری یک پایگاه داده ادامه دهند. اگرچه این رویکرد در کوتاه مدت راحتی فراهم میکند، اما در بلندمدت کاملاً در تضاد با اصول سیستمهای توزیعشده است.
- وابستگی شدید (Tight Coupling): وابستگی بین سرویسها کاهش نمییابد، بلکه در سطح پایگاه داده افزایش مییابد.
- مانع مقیاسپذیری: سرویسهای تحت بارهای مختلف برای منابع پایگاه داده یکسانی رقابت میکنند.
- تضادهای تغییر طرح (Schema): بهروزرسانی جدول در یک سرویس میتواند کد سایر سرویسها را خراب کند.
استراتژیهای حفظ یکپارچگی دادهها
اینکه هر میکروسرویس پایگاه داده خود را داشته باشد (Database-per-Service)، مدیریت یکپارچگی دادهها را پیچیده میکند. تراکنشها از مرزهای یک تراکنش منفرد ACID خارج شده و به ساختارهای توزیعشده منتقل میشوند.
پیادهسازی الگوی Saga
برای مدیریت فرایندهای تشکیل شده از ترکیب تراکنشهای محلی در سیستمهای توزیعشده، از الگوی Saga استفاده میشود. این رویکرد به دو روش مختلف قابل اجرا است:
- Choreography (همآهنگی یا کُئوگرافی): سرویسها با گوش دادن به رویدادهای (events) یکدیگر، تراکنشهای محلی خود را تحریک کرده و فرایند را پیش میبرند.
- Orchestration (ارکستراسیون): یک سرویس مرکزی (saga orchestrator)، ترتیب تمام مراحل را کنترل کرده و عملیات جبرانی (compensating) را در صورت بروز خطاهای احتمالی فعال میکند.
معماری CQRS و مبتنی بر رویداد
در سناریوهای پیچیده نرمافزار سازمانی، تفکیک عملیات خواندن و نوشتن از نظر عملکردی ضروری است. به لطف الگوی جداسازی مسئولیت دستور و پرس و جو (CQRS)، تغییرات دادهها به صورت ناهمزمان با سایر سرویسها به اشتراک گذاشته میشود. بنابراین، معماری پایگاه داده میتواند به راحتی بارهای کاری مختلف را مدیریت کند.
نقشه راه گذار گام به گام
برای تکمیل ایمن فرایند گذار، باید گامهای زیر دنبال شوند:
- مدلسازی دامنه (Domain Modeling): فرایندهای کسبوکار را به مرزهای زمینه محدود (bounded context) صحیح تقسیم کنید.
- جداسازی دادهها: جداول موجود در پایگاه داده مشترک را جزء به جزء با توجه به مسئولیتهای میکروسرویس مربوطه انتقال دهید.
- همگامسازی ناهمزمان: برای رفع ناسازگاری دادهها بین سرویسها از صفهای پیام قابل اعتماد (message brokers) استفاده کنید.
سناریوی فرضی: ادغام سفارش و موجودی
هنگام بررسی این سناریوی تئوریک، اجازه دهید جداسازی سرویسهای سفارش و موجودی را در یک معماری سازمانی مبتنی بر تجارت الکترونیک بررسی کنیم. در ساختار یکپارچه، هنگامی که سفارشی ایجاد میشد، جدول موجودی مستقیماً بهروز میشد. در تبدیل به میکروسرویس، این دو حوزه تفکیک شده و پایگاه داده اختصاصی هر سرویس پیکربندی شد. هنگامی که کاربر سفارشی ثبت میکند، سرویس سفارش رکورد جدید را در پایگاه داده خود نوشته و یک رویداد SiparisOlusturuldu (سفارش ایجاد شد) منتشر میکند. سرویس موجودی با گوش دادن به این رویداد، مقدار موجود در پایگاه داده خود را کاهش میدهد. با این حال، در اینجا یک تفاهم تجاری (trade-off) حیاتی ظهور میکند: به جای سازگاری قوی (strong consistency)، سازگاری نهایی (eventual consistency) پذیرفته میشود. اگر سرویس موجودی نتواند در اثر قطعی شبکه یا خطاهای صف پیام پاسخ دهد، جدول سفارش و جدول موجودی فوراً با هم هماهنگ نخواهند بود. برای مدیریت این خطا، عملیات جبرانی فعال میشوند. اگر موجودی ناکافی بماند، ارکستراتور Saga دستور جبرانی را برای لغو سفارش ارسال میکند. در مرحله مدیریت خطا، با راهاندازی مکانیسمهای صف نامه مرده (dead-letter queue)، پیامهای پردازش نشده ثبت شده و به مدیران سیستم فرصت مداخله دستی داده میشود.
چکلیست دقیق گذار و پیادهسازی
به منظور مدیریت بدون ریسک فرایند گذار از اشتراکگذاری پایگاه داده به پایگاههای داده ایزوله میکروسرویس، باید چکلیستی متشکل از مراحل مشخص اجرا شود. در مرحله اول، زمینه محدود (bounded context) هر سرویس باید با مرزهای دقیق تعیین شود و پرسوجوهای join مستقیم پایگاه داده بین سرویسها باید کاملاً حذف شوند. در مرحله دوم، در حالی که مالکیت جداول مشترک به یک سرویس منفرد واگذار میشود، لایههای بازتابی مبتنی بر API یا CQRS برای دسترسی فقط خواندنی سایر سرویسها به این دادهها ایجاد میشوند. در مرحله سوم، ابزارهای نوشتن دوگانه (dual-write) یا تغییر دادهها (CDC) به پروژه ادغام میشوند تا زمان خرابی (downtime) در طول انتقال دادهها به حداقل برسد. در مرحله چهارم، سناریوهای خرابی تراکنشهای توزیعشده از ابتدا تا انتها شبیهسازی شده و تحت آزمایشهای بار قرار میگیرند. بزرگترین شکستی که در این فرایند با آن مواجه میشود، پردازش تکراری (duplicate) پیامها در جریانهای ناهمزمان است. برای جلوگیری از این امر، طراحیهای مصرفکننده همتوان (idempotent - تولیدکننده نتایج یکسان در فراخوانهای مکرر) باید حتماً در پایگاه کد گنجانده شوند. در مرحله نهایی، تمام معیارهای سیستم با ابزارهای مانیتورینگ زیر ذرهبین قرار گرفته و گلوگاههای عملکردی برطرف میشوند.
منابع
- Kurumsal Yazılım & ERP — Cy Logic Software